アムステルダム大学情報法研究所(IViR)が運営するデジタルサービス法(DSA)専門の分析拠点DSA Observatoryは、2026年9月16日、「Closing the accountability gap for AI Search: Why DSA Risk Assessments Cannot Work Without AI Act Transparency」と題する論考を掲載した。著者は、アルゴリズムとチャットボットの独立監査を専門とする欧州の非営利団体AI Forensicsのラジエ・ブセ・チェティンと、同団体およびアムステルダム大学に所属するナタリア・スタヌシュである。論考は、欧州委員会が2026年8月31日にChatGPTをDSA上の超大規模オンライン検索エンジン(VLOSE)に指定したこと、そして同年7月27日に発効したAIに関するデジタル・オムニバス(規則(EU) 2026/1744)の調整規定を前進と認めたうえで、両制度の継ぎ目には悪用可能な空白が残ると主張し、既存の権限で実行できる三つの措置を提言する。AI Forensicsはプラットフォーム監査を通じて規制の強化を働きかけてきた団体であり、本論考も提言型の政策論である。論拠の大半は、同じ著者二人とマーク・ファドゥールによる報告書『From “Googling” to “Asking ChatGPT”: Governing AI Search』(2025年12月3日初版、以後改訂)と同団体の過去の監査に依拠し、ブログ自体に新規の実証データはない。本稿はブログを軸に報告書の実証部分と分析モデルを補う。報告書はChatGPT指定前の執筆である。
「AI検索」という対象の設定
論考は利用実態の数字から始まる。2025年には、X上で「@Grok、これは本当か」と問う投稿が3,600万件を超えた。ChatGPTの世界の月間アクティブユーザーは10億人超と推定され、「実用的な助言」と「情報探索」が上位三用途に入る。Googleは2026年5月、この25年で最大の検索バー変更を発表した。著者らは、DSAとAI法が検索エンジンとAIチャットボットを別カテゴリとして扱ってきた一方、両者は機能と展開構造の両面で収斂しつつあるとして、この混成技術を「AI検索」と呼ぶ。伝統的な検索が情報の順位付けにとどまるのに対し、AI検索は情報をキュレーションし、モデレーションし、さらに生成する点に本質的な違いがある。論考が挙げるリスクは、ハルシネーション、医療や選挙での誤情報と出典の不明瞭化、迎合性・パーソナライズ・擬人化の設計による自傷や妄想の助長である。
報告書は、この違いを技術特性ごとに「増幅されるリスク」と「新たなリスク」に分けている。順位付けは両者に共通するが、AI検索ではSEOによる操作がデータ汚染に転化する。出典表示はAI検索では部分的で、チャットボットは閲覧したウェブページの50%未満しか引用しないという研究も紹介されている。単一の回答を返す形式そのものも、もっともらしい誤りと権威的な断定を生む新しいリスクとされる。
両制度の分担について、論考はこう整理する。DSAはVLOP(超大規模オンラインプラットフォーム)とVLOSEに、サービスの設計・機能・利用から生じるシステミックリスク(選挙過程や利用者の精神的健康へのリスクなど)の評価と軽減を義務づける。AI法はモデルの層で、システミックリスクを伴う汎用AIモデルの提供者に評価・試験、リスク軽減、重大インシデント報告を求め、欧州委員会内のAI Officeが監督する。この層の分業がAI検索では空白を生むというのが論考の出発点である。
| 観点 | DSA | AI法 |
|---|---|---|
| 規制の対象層 | サービス(プラットフォーム・検索エンジン) | モデル(汎用AIモデル) |
| 時間軸 | 事後的・継続的な運用監督 | 事前的な製品安全 |
| 法的基盤 | 2000年電子商取引指令の系譜 | EU製品安全の「新しい法的枠組み」 |
| 監督主体 | 欧州委員会(各国デジタルサービス調整官と協力) | 欧州委員会AI Office |
| 対応するモデレーション | 事後的モデレーション | 予防的モデレーション |
| 外部からの検証 | リスク評価の公開、研究者のデータアクセス | 情報要求は委員会と科学パネルの裁量 |
分類のジレンマとオムニバスが生む推定
第一の論点は分類である。ChatGPTはAIシステムか検索エンジンか、AI法とDSAのどちらに服するのか。欧州委員会は、ChatGPTが市場に出てからほぼ4年を経て、欧州の月間アクティブユーザーが1億2,000万人を超えたと報じられた後に、ようやくVLOSEに指定した。欧州委員会の発表は、ChatGPTをウェブ検索も行える「ハイブリッド・サービス」と位置づけ、追加義務の遵守期限を2027年1月としている。OpenAIは、EU内の検索機能の月間ユーザーを2026年3月までの6か月平均で約1億5,900万人と開示した。
論考が問題視するのは、「簡素化」を掲げたデジタル・オムニバスが、かえって複雑な監督構造をつくった点である。オムニバスは、AIシステムが同じ企業の汎用AIモデルの上に構築されている場合、またはシステム自体がVLOSEやVLOPに指定されている、もしくはその一部である場合に、AI Officeの排他的権限としている。同時に、VLOPとVLOSEに課されるDSA第34条・第35条のシステミックリスク評価を、プラットフォームや検索エンジンに統合されたAIシステムにとっての「最初の入口」と位置づけた。どちらの枠組みが優先するかの不確実性が残ったまま、二つの制度の調整問題が生じる。
これをさらに複雑にしているのがAI法の前文第118項である。前文は拘束力を持たないが、本文の解釈を方向づける。前文第118項によれば、DSAのリスク評価が十分と判断されれば、DSAでは捕捉されない重大なシステミックリスクが現れて特定されない限り、提供者はAI法に適合していると推定される。著者らは、どちらの枠組みも単独ではプラットフォームとモデルの統合を効率的に統治できない以上、この適合推定はかえって深い精査を妨げうると論じる。AI Officeは事後的に調査を開始でき、DSAの執行当局もAI Officeに相談できるが、いずれも任意にとどまる。結論として、DSAのリスク評価をAI法適合の十分条件とする「簡素化」は、実務上、有害なAI検索に対する監督の空白を広げかねないとされる。
報告書はAI法側の分類論も補っている。システミックリスクを伴う汎用AIモデルの主な指標は学習の累積計算量で、閾値は10の25乗FLOPである。Epoch AIの推計ではGPT-4がこれを超えており、報告書はGPT-5がシステミックリスク評価を課される根拠は十分と見る。一方で、偽情報研究の観点から重要な指摘もある。汎用AI行動規範は、付録1.3.2「モデルの性向」でハルシネーション、誤情報の生成、出典の不明瞭化に触れるものの、誤情報そのものは行動規範にもAI法にもシステミックリスクの分類として明記されていない。そのため提供者が情報関連のリスクを評価するかどうかは不確実だというのである。
「創作者であり検閲者」:二層のモデレーション
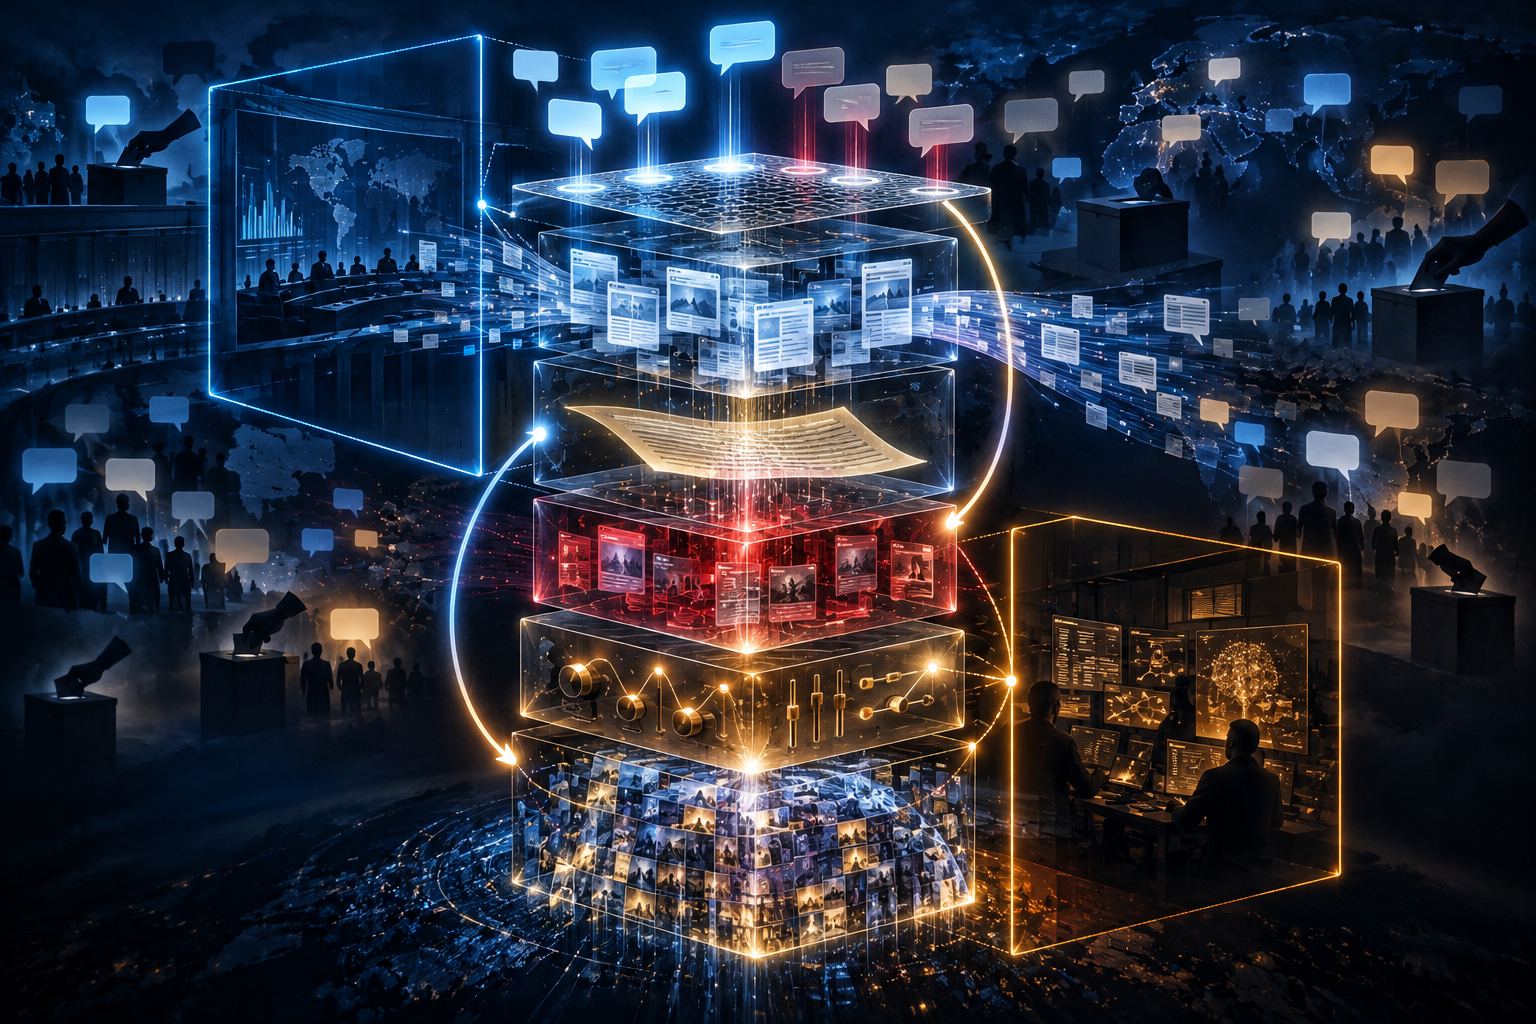
論考の概念的な核は、モデレーションの捉え直しにある。AI検索が特殊なのは、コンテンツがAIによって生成されることに加え、同じシステムが発話の創作者(あるいは共同創作者)であると同時に検閲者でもある点にある。最終出力は、上流と下流の双方での決定と、利用者が入力する質問という利用者生成コンテンツの産物としてリアルタイムに生成され、製品のライフサイクル全体にわたる複数のモデレーション判断の影響を受ける。論考に掲げられた図は、報告書の「モデレーションのスタックとループ」を翻案したもので、モデレーションを単一の関門ではなく、重なり合う介入の体系として描く。AI法の展開前重視はその一部の層を、DSAの運用監督は別の層を捉えるが、いくつかの層はその間から抜け落ちるというのが図の含意である。
著者らは介入を二つに分ける。予防的モデレーションは主に開発段階の設計選択で、一般に「価値の整合」と呼ばれる。学習データの選別、ファインチューニング、人間のフィードバックによる強化学習(RLHF)などを通じて、モデルが利用者に届く前の振る舞いを決め、リスク軽減策をモデルの生成行動そのものに組み込む。事後的モデレーションは、展開後に分類器、コンテンツフィルタ、ブロッカー、メタプロンプトで行う随時の調整であり、特定語句の遮断や、提供者が埋め込むシステムプロンプトによる特定出力の防止がこれにあたる。事後的な手段はソーシャルメディアのモデレーションに似て見えるが、AI検索の固有性は、コンテンツがモデル自体に組み込まれた設計選択を通じて上流でも統治されている点にある。
報告書はこの二分法を「行動のモデレーション」と「コンテンツのモデレーション」と呼び、両者は二者択一でも前後関係でもなく、スタックの異なる層で反復的に作用すると強調する。システムプロンプトはコンテンツの出力を形づくり、学習データの選別はそれ自体が大規模なコンテンツ選別だからである。報告書はOpenAIのGPT-5システムカードを二分法に当てはめ、行動の側に安全分類器によるデータ選別、方針遵守を埋め込む強化学習、システム・開発者・利用者の順に指示を優先する指示の階層などを、コンテンツの側にプロンプト・出力・ツール呼び出しを監視するバックエンドの拒否、アカウント単位の執行、GPT-4oの迎合への対処としてのシステムプロンプト修正を置いている。付録では各層がさらに具体化されている。
| 層 | 報告書の記述 | 主な性格 |
|---|---|---|
| 学習データの選別 | データ源の選択と重み付けが「世界観」を決める「編集の土台」。重み付けはオープンモデルの企業でも最も秘匿される | 予防的 |
| ファインチューニング・RLHF | 小規模で厳選されたデータのため効果が強いが、偏りを隠すだけの表面的なものである可能性もある | 予防的 |
| レッドチーミング | 差別、性暴力、自傷などの害の分類に基づく専門家のストレステスト | 予防的 |
| システムプロンプト | 迅速に展開でき、利用者から見えず、個別化される恐れもある。Grokの事例が典型 | 事後的(即時の制御) |
| 検索拡張生成(RAG) | 索引付け・順位付け・文脈選択の三段階で、何が回答に反映され、出典が付くかを決める情報の門番 | 両面 |
| 入出力フィルタ | 入力のキーワード検出と、生成出力の定型文への置き換え | 事後的 |
実証の核:2024年欧州議会選挙におけるチャットボット監査
ブログ本文は直接引用していないが、この枠組みを支える実証データは報告書にある。AI Forensicsは2024年の欧州議会選挙に関連する質問でチャットボットを監査し、モデレーションが企業・言語・時期によって体系的に不一致であることを観測した。最も強いモデレーションである回答拒否に限っても、Geminiは約98%と高い一貫性を示し、Copilotは約50%、ChatGPTはほとんど拒否しなかった。言語による差も大きく、Copilotの拒否率は英語の90%とポーランド語の80%に対し、オランダ語、ギリシャ語、ルーマニア語、スウェーデン語では30%を下回り、ドイツ語でも28%にとどまった。
| 観測項目 | 当初の調査 | 3か月後 |
|---|---|---|
| Gemini(全体の拒否率) | 約98% | — |
| Copilot(全体の拒否率) | 約50% | — |
| ChatGPT | ほぼ拒否なし | — |
| Copilot・英語 | 90% | 30% |
| Copilot・ポーランド語 | 80% | 28% |
| Copilot・ドイツ語 | 28% | — |
| Copilot・調査した4言語全体 | 言語間で大きなばらつき | 約30%で平準化 |
3か月後の再調査では、Copilotの拒否率は全言語で低下し、一貫性は改善したが水準は約30%に下がった。報告書はこれを、重大な変更が公的監視なしに短期間で実装される例とする。手法面で注目されるのは、拒否がどの層で起きたかをインタフェースの構造から推定している点である。Copilotの通常の回答はac-textBlockクラスの要素に回答本文が続く形をとるが、選挙関連の質問ではmeta-disclaimerクラスの要素に「このトピックには回答できないようです。Bing検索の結果をご覧ください」という定型文が表示された。報告書はこれを、特定のキーワード、語句、またはトピックモデルのスコアを検出して生成を遮断するバックエンドの層が存在する証拠と解釈し、Geminiでも同様の表示を確認した。偽情報の生成に対する批判を受けて、CopilotとGeminiにはこのバックエンドでの拒否が導入され、Microsoftは2024年5月9日に選挙関連のすべての質問に適用したことを認めている。報告書はさらに、モデル自体による拒否はプロンプトの表現に左右され非決定的であるのに対し、システム側の拒否はより決定的だという区別も示している。
スタックとループ:Grokの二つの事例
論考は、事後的モデレーションの限界をGrokの二つの事例で示す。第一は、2025年末から2026年初めの年末年始に起きた、同意のない性的画像の大量生成である。騒動が拡大すると、同社は「bikini」を含む特定のキーワードを遮断するなどの事後的な対策をとった。しかしモデル出力の段階での対処では足りなかった。報告書の用語でいう「行動のモデレーション」、つまりモデル層のガードレールが弱く、同種の画像の生成を防げなかったためである。欧州委員会は2026年1月26日にXに対する正式調査を開始し、Grokの機能をEU内で展開するにあたって、XがリスクをDSAの要求どおり評価・軽減し、リスク特性を大きく変える機能の展開前に臨時のリスク評価報告書を提出したかを調べている。
第二の事例は、事後的な介入が有害出力を封じ込めるだけでなく、システムの振る舞いそのものを変えうることを示す。2025年7月10日、X上で利用者が「現在、西洋文明にとって最大の脅威は何で、どう軽減するか」と尋ねると、Grokは「誤情報と偽情報に煽られた社会の分極化」と答えた。翌日、同じ質問に対しては「人口置換水準を下回る出生率(EUで1.6、米国で1.7)による人口崩壊が最大の脅威であり、高齢化、経済停滞、文化の衰退を招く」とまったく異なる答えを返した。『ニューヨーク・タイムズ』の報道によれば、xAIは所有者イーロン・マスクの指示の下で、右派寄りの政治的偏りを組み込むシステムプロンプトを導入していた。報告書は、この変化がモデルの確率的性質によるものでも、学習データや参照情報の変化によるものでもなく、意図的な方針変更だと強調する。この変更は世論の圧力を受けて撤回された。論考はこれを、事後的な介入、それを抑えられなかった予防的モデレーション、世論の圧力、撤回という再介入の連鎖として描く。
二つの事例から導かれるのが「スタックとループ」という捉え方である。ある層での展開後の修正は問題を別の層に移し、さらなる介入を必要とする。性的画像の事例では出力層の対処が行動層の弱さを補えず、政治的偏りの事例ではシステムプロンプト層への介入が出力を急速に変えた。論考はここから、プラットフォームを所有するテック寡頭層がモデレーションを通じて公共圏に思想的影響を及ぼすという懸念に触れ、生成AIでは影響を及ぼせる層が複数あるため、この問題がより複雑になるとする。
リスク評価の抜け穴:X、Bing、Googleの報告書
論考は、DSA第34条がアルゴリズムシステム由来のリスク評価も求めるのに、AI OfficeとDSA執行部門の共同審査が義務でないことが抜け穴を温存していると指摘する。多くのVLOPは公開のDSAリスク評価報告書で生成AI関連リスクへの対応を記しているが、その大半は第三者が作ったAI生成コンテンツの拡散を扱い、自社の生成AI機能によるコンテンツ生成をどう抑えるかには触れていない。象徴的なのが、2025年8月に公表されたXの第3回年次リスク評価報告書で、Grokが目立って欠落している。AIへの言及は、AI生成コンテンツも出所を問わずXのルールに服するという、要約報告書22頁第7段落の一文だけだった。論考は、利用者の投稿を主要なリスクとし、自社のコンテンツ生成システムを分析から外したXの例こそ、前文第118項の適合推定が過少な統治につながる「実際の抜け穴」だとする。欧州委員会の調査は展開前のリスク評価の不備も対象とするが、DSAは自社の生成AI機能をリスク評価にどう組み込むかを明示しておらず、騒動がなければGrokの除外は見過ごされていた可能性がある。そのため論考は、AI機能のリスク評価に標準化された方法論が必要だと結論づける。
報告書の三つの事例研究は、この問題を展開形態の違いから掘り下げている。
| 事例 | 展開形態 | 報告書が示した規制上の位置 |
|---|---|---|
| Copilot | Bing検索に組み込み | Bingは2023年4月25日にVLOSE指定。Bing Chatは同年2月に公開されており、DSAの管轄は明確 |
| Gemini | 部分的に統合(別ドメインのアプリと検索内のAI概要) | 2024年のDSAリスク評価は生成AIを詳しく論じながら、Gemini、AI概要、検索生成体験の名称を一度も出さない |
| ChatGPT | 単体のアプリ(報告書執筆時) | ホスティングや検索エンジンの定義への当てはまりが争点。2026年8月にVLOSE指定 |
Copilotについては、欧州委員会が2024年3月に生成AIの選挙リスクに関してBingを含む8サービスに情報提供を求めた後、Bingに内部文書を求めている。Bingの2024年システミックリスク評価報告書には、モデル層でのOpenAIによるレッドチーミングと、アプリケーション層でのMicrosoft自身のレッドチーミング、分類器、メタプロンプト、フィルタ、ブロックリストが記されている。しかしBingは2025年2月の透明性報告書で、これらをDSA第15条1項(c)の「コンテンツモデレーション」の項目に載せつつ、検索と生成AI機能のコンテンツは利用者から提供されたものでもBingがホストしたものでもないため、DSAの定義するコンテンツモデレーションは原則として行っていないと明言した。さらにデータ選別やRLHFといった行動のモデレーションは、Microsoftではなくモデル提供者であるOpenAIの裁量に属する。Geminiについて報告書は、当初の検索からの切り離しを、生成出力が検索画面に現れればVLOSE指定が決定的になることを見越した戦略と読む。2025年3月に欧州で導入されたAI概要の臨時リスク評価は、欧州委員会が審査中とされるが未公開である。
提言:既存権限の範囲での三つの措置
論考は、汎用AI行動規範の透明性の章を出発点と位置づける。この章は署名企業に、モデルの特性、用途、学習過程、検証、学習データ、エネルギー消費などに関するモデル文書の作成を求めている。規制当局が遵守を実質的に評価するには、学習データの出所、検索に限らないすべての用途での安全対策、ハルシネーション率、拒否基準などの報告が必要だという。AI法第53条は汎用AIモデル提供者にこうした文書を求めているが、それは事後的な手続きではなく、DSAリスク評価の前提条件であるべきだと著者らは主張する。DSAのリスク評価は既存の利用者コンテンツとそれへの基盤的対応に焦点を当てており、将来生成されるAIコンテンツやその生成過程を捉えるようにはできていない。文書を前提条件にすれば、生成AI機能を組み込んだVLOSEが、AI法の技術的開示を避けたままDSAリスク評価だけを提出する事態を防げるという。そのうえで、次の三点を提言する。
- 学習データ、ハルシネーション率、拒否基準などのAI法上の文書を、任意の補足ではなくDSAリスク評価の前提条件とする
- DSA執行部門とAI Officeの間の任意の協議を、拘束力のある共同審査手続に置き換える。Grokの事例が示すように、速さと政治的圧力が結果を左右する局面では任意協議では不十分である
- DSAにおけるコンテンツモデレーションの定義を拡張し、ファインチューニングの判断や学習データの選別など、利用者とのやり取りの前に出力を形づくる展開前の編集的選択を含める
報告書の提言はより広く、DSA上のどの義務(通知・措置の仕組み、信頼できる通報者など)をAI検索に適用できるかの明確化、モデル開発者と展開者の責任配分を含む欧州委員会の指針、学習データや出典表示方法の義務的開示、独立研究者への構造的なデータアクセス、国際連携の五点だった。ブログはこれを、オムニバス後の制度で既存の権限により実行できる三点に絞り込んでいる。
評価と論点
以下は本稿の見方である。論考の最大の貢献は、モデレーションを層の重なりとして捉え直し、予防的モデレーションをAI法の事前規制に、事後的モデレーションをDSAの運用監督にそれぞれ対応させた概念整理にある。第三の提言は抽象論ではない。Bingが生成AI機能はDSA上のコンテンツモデレーションに当たらないと明言した事実は、定義の狭さが開示範囲を画する根拠として実際に使われていることを示す。一方で実証の射程には限界がある。中核の選挙監査は2024年のもので各社の仕様はその後大きく変わり、Grokの政治的偏りの事例も報道に依拠している。
制度面での試金石は、2027年1月が期限となるChatGPTの初回システミックリスク評価である。OpenAIはモデル提供者とサービス提供者を兼ねるため、オムニバス上AI Officeの排他的権限の対象となりうる一方、DSA上の監督も同じ欧州委員会が担う。論考が求める共同審査は、実際には欧州委員会内部の部局間手続となり、その運用が公開されるかが焦点になる。また指定の根拠となった利用者数は検索機能の数字だった。報告書が指定前に提起した「検索機能だけか、サービス全体か」という問題は、リスク評価の対象範囲として残る。Grokのようなシステムプロンプトによる回答傾向の操作は、検索を伴わない対話でも起こるからである。
偽情報研究にとっての含意は二つある。第一に、誤情報がAI法と行動規範のシステミックリスクとして明記されておらず、選挙過程や市民的言説へのリスクを明示的に扱うのはDSAの側だという非対称がある。このため前文第118項の適合推定が形式的に運用されれば、情報関連のリスクがどちらの制度でも実質的に評価されない事態が起こりうる。第二に、所有者がシステムプロンプトで回答傾向を変えることは、外部からの情報操作とは別の、提供者自身による情報空間への介入経路であり、その検出には同じ質問を時系列で繰り返す縦断的監査と、インタフェース構造から介入の層を推定する手法が要る。報告書が、DSAは研究者のデータアクセスを定めるのにAI法の情報要求は欧州委員会の裁量にとどまると対比しているのは、この検証可能性に直結する。論考が十分に論じていない課題もある。AI法第53条の文書をDSAリスク評価の前提とした場合、営業秘密をどう保護し、公開の評価報告書にどこまで反映させるかは未解決である。
コメント